Gemini Robotics 2: Google DeepMind enseña a los robots a pensar mientras se mueven
Google DeepMind ha presentado Gemini Robotics 2, una nueva generación de modelos de inteligencia artificial para robots que busca unir razonamiento, visión y movimiento en un mismo sistema. La gran novedad no consiste únicamente en manipular objetos con una mano robótica: la tecnología puede coordinar el cuerpo completo, seguir el progreso de una tarea mientras la ejecuta y repartir el trabajo entre varias máquinas.
Qué es Gemini Robotics 2
Gemini Robotics 2 no es un único modelo, sino una familia con funciones complementarias. El modelo principal de visión, lenguaje y acción convierte lo que el robot ve y las instrucciones que recibe en movimientos físicos. Gemini Robotics ER 2 actúa como cerebro de alto nivel: conversa, interpreta el entorno, divide un objetivo en pasos y decide qué herramienta o controlador debe utilizar. Finalmente, Gemini Robotics On-Device 2 está pensado para ejecutar acciones localmente en la propia máquina.
Esta separación es importante. Planificar “recoge la basura y ordena la habitación” exige una comprensión diferente a controlar el equilibrio, flexionar las piernas o cerrar los dedos alrededor de un objeto. DeepMind combina ambos niveles para que una orden natural termine convertida en una secuencia de acciones concretas.
Del movimiento de las manos al control de todo el cuerpo
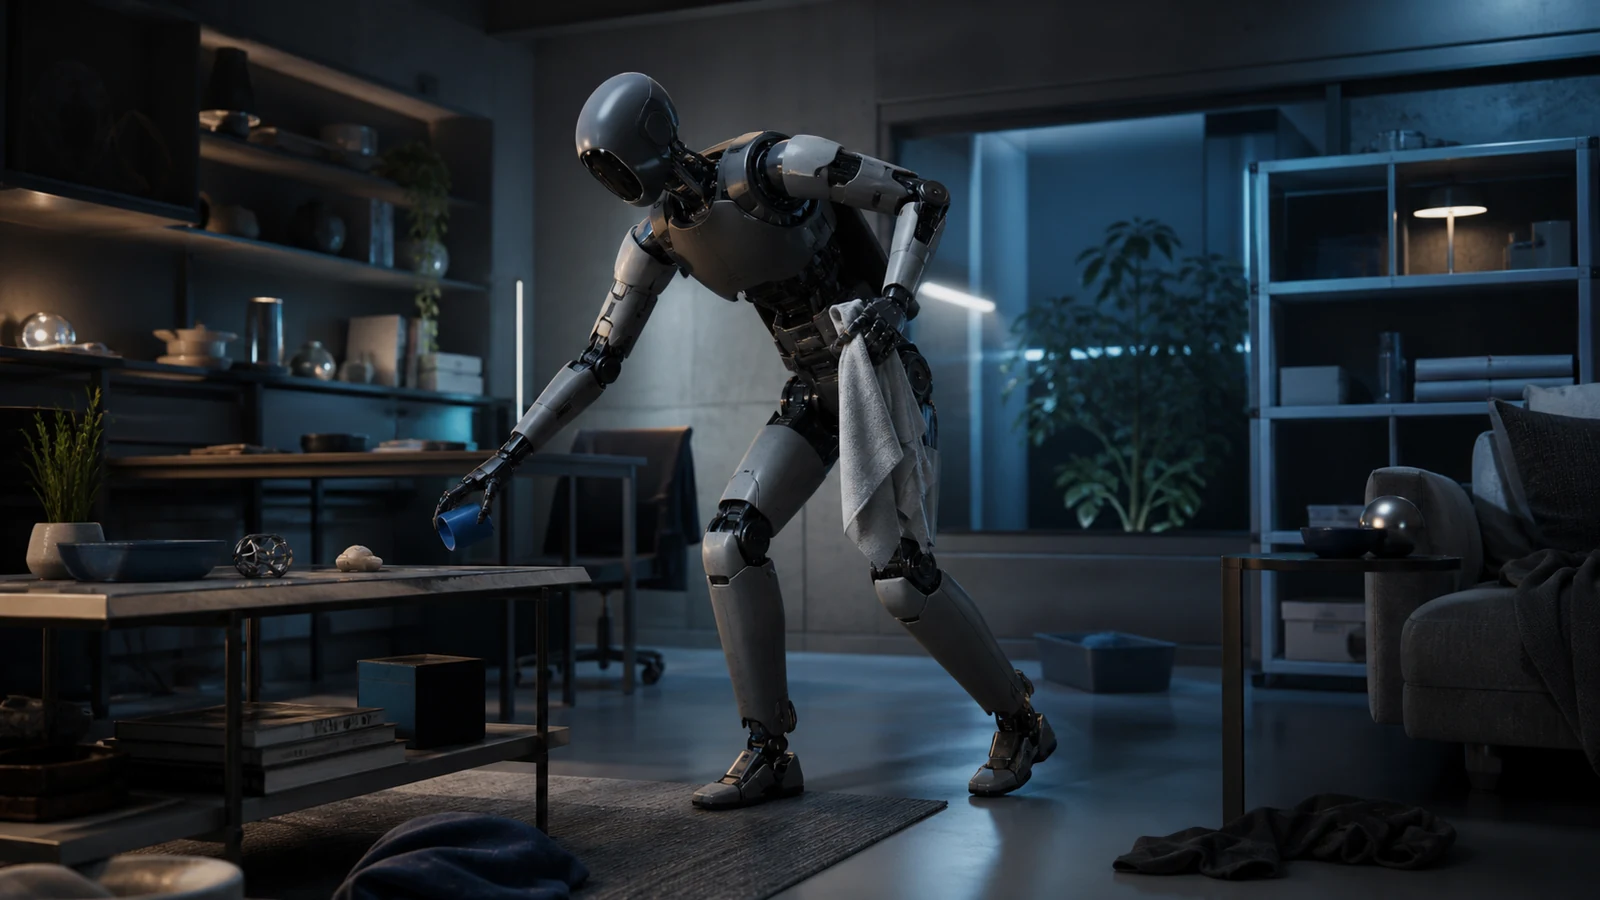
La generación anterior destacó en tareas delicadas realizadas con brazos y pinzas. Gemini Robotics 2 amplía el alcance al cuerpo entero. En las demostraciones, robots humanoides caminan hacia un objeto, se agachan, lo recogen y lo colocan en otro punto sin separar artificialmente cada movimiento. También aparecen acciones de motricidad fina como enroscar una bombilla, cerrar una bolsa o manipular recipientes.
La cobertura en español de Cinco Días recuerda un matiz esencial: las tareas mostradas fueron entrenadas específicamente mediante teleoperación humana, vídeos y simulaciones. Estamos ante robots más generales y adaptables, pero no ante máquinas capaces de improvisar con fiabilidad cualquier trabajo doméstico.
Un robot que observa su propio trabajo
Uno de los avances más interesantes está en el uso continuo del vídeo. Gemini Robotics ER 2 no mira una escena solo antes de actuar: recibe la secuencia, calcula cuánto ha avanzado y comprueba si cada paso ha terminado correctamente. Si algo falla, puede repetirlo o modificar el plan sin reiniciar todo el proceso.
Google denomina a estas capacidades clasificación de progreso y detección de momentos. La primera divide el avance en varios niveles y alcanzó un 57,4% de precisión en las evaluaciones de la empresa. La segunda intenta localizar el instante exacto en que se completa una acción, por ejemplo cuándo dejar de verter líquido o cuándo una bombilla ya está ajustada. Es una habilidad poco vistosa, pero decisiva para evitar movimientos innecesarios o peligrosos.
Pensar mientras se mueve
En el mundo físico no resulta práctico que el robot se detenga varios segundos después de cada gesto para calcular el siguiente. El anuncio oficial de Google explica que ER 2 puede razonar sobre lo que viene después al mismo tiempo que ejecuta la acción actual. Para ello se integra con Gemini Live API, cuya comunicación bidireccional está optimizada para tareas sensibles a la latencia.
ER 2 está basado en Gemini 3.5 Flash, admite texto, imagen, vídeo y audio, y cuenta con una ventana de contexto de hasta 128.000 tokens. También puede llamar a herramientas como Google Search o funciones definidas por el desarrollador. Un robot podría consultar una instrucción, localizar un objeto y delegar el desplazamiento o la manipulación en controladores especializados.
Varios robots, un solo plan
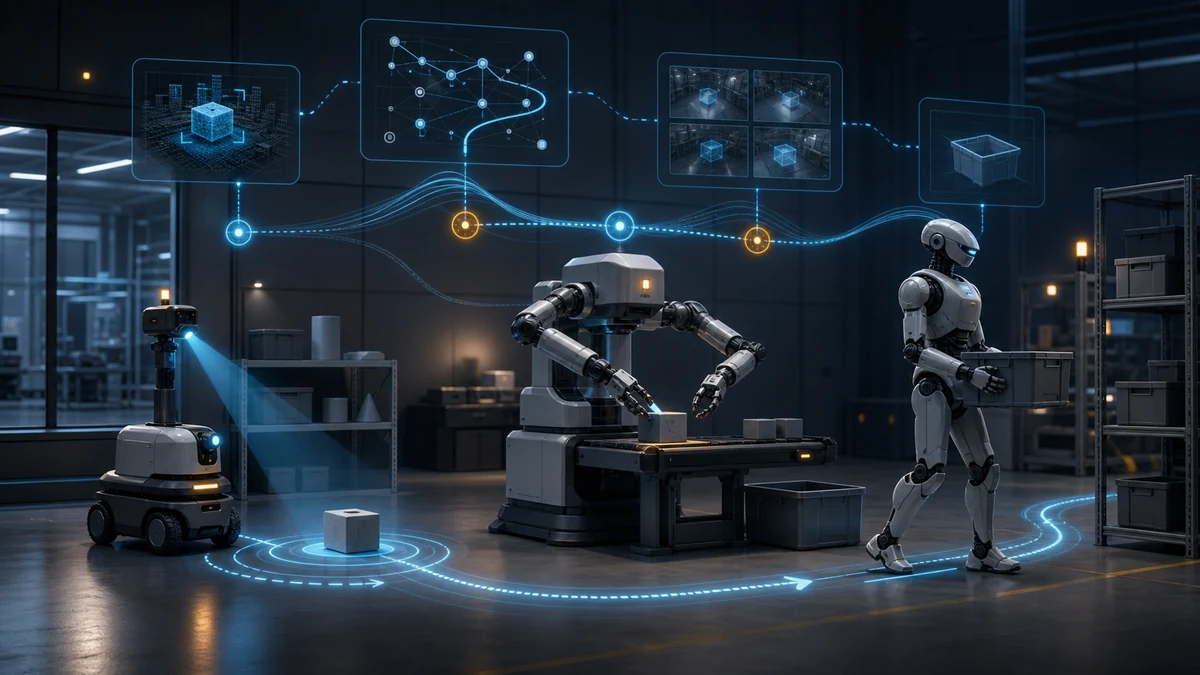
Gemini Robotics ER 2 introduce además la colaboración entre robots diferentes. El sistema puede distribuir un flujo de trabajo entre una máquina móvil, un brazo manipulador y un humanoide, cada uno con sus propias capacidades. En un almacén, por ejemplo, uno podría localizar una caja, otro clasificar su contenido y un tercero transportarla.
Esto acerca la IA física a escenarios industriales y logísticos donde ya conviven máquinas especializadas. La promesa no es reemplazarlas por un único robot universal, sino proporcionar una capa común que entienda el objetivo y coordine recursos distintos. Si funciona de forma fiable, podría reducir buena parte de la programación manual necesaria para conectar cada sistema.
Disponibilidad y límites de seguridad
Gemini Robotics ER 2 ya está disponible para desarrolladores mediante Gemini API y Google AI Studio, y se ofrece como vista previa privada en Gemini Enterprise Agent Platform. Google ha publicado ejemplos para configurar agentes físicos. En cambio, los modelos que producen directamente las acciones y la variante On-Device 2 continúan en acceso limitado para socios de robótica.
La propia ficha del modelo pide prudencia antes de utilizarlo en entornos públicos, comerciales o de producción. Además, indica que no debe emplearse en trabajos críticos como sanidad o transporte, donde un fallo podría provocar lesiones o daños. Es una advertencia razonable: una alucinación en una pantalla molesta; la misma decisión equivocada en una máquina con fuerza física puede ser mucho más grave.
Gemini Robotics 2 representa un avance tangible, aunque todavía experimental. Coordinar el cuerpo completo, verificar el progreso y colaborar entre máquinas son piezas necesarias para robots útiles fuera de una demostración. Sin embargo, el salto decisivo no llegará cuando un robot complete una tarea llamativa una vez, sino cuando pueda repetirla cientos de veces, ante cambios inesperados y con una seguridad comparable a la de los sistemas industriales actuales.