Gemini 3.5 Transcribe: Google convierte la voz en texto limpio y contextual
Google ha lanzado Gemini 3.5 Transcribe, un nuevo modelo de inteligencia artificial especializado en convertir voz en texto. No se limita a reconocer palabras: puede detectar idiomas, adaptarse a vocabulario técnico y, cuando se le pide, limpiar muletillas, resolver correcciones hechas al hablar y devolver un texto ya puntuado y ordenado.
El lanzamiento apunta a dos públicos. Por un lado están los desarrolladores que necesitan subtítulos, actas, análisis de llamadas o agentes de voz. Por otro, Google ya está incorporando esta tecnología a productos de consumo como Gboard y la aplicación de Gemini para macOS. Su llegada a Chrome, todavía sin fecha concreta, permitirá dictar directamente en campos de texto de la web.
Qué es Gemini 3.5 Transcribe
Gemini 3.5 Transcribe es un modelo de reconocimiento automático del habla, o speech-to-text, construido sobre las capacidades de comprensión de audio de Gemini. Acepta una grabación o un flujo de sonido y devuelve texto, pero no es un chatbot de voz ni un sistema de traducción hablado. Su tarea concreta es escuchar y transcribir con rapidez.
En el anuncio oficial, Google lo presenta como su modelo de voz a texto más preciso hasta la fecha. Admite más de 85 idiomas y configuraciones regionales, puede cambiar de idioma dentro de una misma conversación y reconoce términos especializados mediante una lista personalizada de hasta 1.000 palabras o expresiones. Google advierte, no obstante, de que normalmente se obtienen mejores resultados con listas de hasta 100 términos bien escogidos.
Esa función resulta útil cuando el audio contiene nombres de productos, siglas médicas, referencias jurídicas o códigos de pedidos que un transcriptor genérico suele interpretar mal. También está pensado para trabajar con ruido de fondo, acentos regionales y combinaciones de idiomas, aunque el rendimiento real dependerá de la calidad del sonido y de cada lengua.
Dos modelos para audio en directo y grabaciones
Google ha dividido el servicio en dos variantes. gemini-3.5-transcribe-live recibe audio continuamente mediante la Live API y entrega resultados parciales y definitivos con una latencia inferior a un segundo. Está pensado para subtítulos en directo, interfaces controladas por voz y conversaciones donde esperar varios segundos rompería la experiencia.
Las sesiones en vivo están limitadas actualmente a diez minutos y no ofrecen separación de hablantes ni marcas de tiempo por palabra. Para esos trabajos está gemini-3.5-transcribe, la variante destinada a archivos pregrabados. Puede procesar hasta una hora por solicitud, aunque el límite baja a 30 minutos cuando se activan la diarización o las marcas temporales.
En una grabación, el modelo puede atribuir las intervenciones a un máximo de ocho voces. La propia documentación considera experimental la identificación cuando hay tres o más hablantes, un matiz importante para mesas redondas o reuniones numerosas. Las marcas de tiempo a nivel de palabra también pueden reducir algo la precisión general.
Transcripción literal o texto ya corregido
La novedad más interesante es la elección entre dos modos. Verbatim, activado por defecto, conserva muletillas, repeticiones, pausas y comienzos en falso. Es la opción adecuada cuando importa registrar exactamente lo dicho, como en una entrevista, una declaración o una revisión jurídica.
El modo Smart busca legibilidad. Si alguien dice «quedamos el martes… no, mejor el miércoles», el resultado conserva solo el miércoles. También convierte una enumeración hablada en una lista, normaliza fechas y cantidades y elimina los habituales «eh» o «mmm». Ahorra edición, pero deja de ser una reproducción literal. Además, Smart no puede combinarse actualmente con diarización ni marcas de tiempo.
Según recoge Europa Press, las mediciones de Artificial Analysis sitúan la tasa media de error por palabra en el 4% para streaming y en el 2,6% para audio pregrabado. Son cifras prometedoras, aunque no garantizan el mismo resultado en los 85 idiomas, con todos los acentos o bajo cualquier ruido. Google también afirma que el tiempo hasta la transcripción final mejora un 70% frente a Chirp 3.
Casos de uso de Gemini 3.5 Transcribe
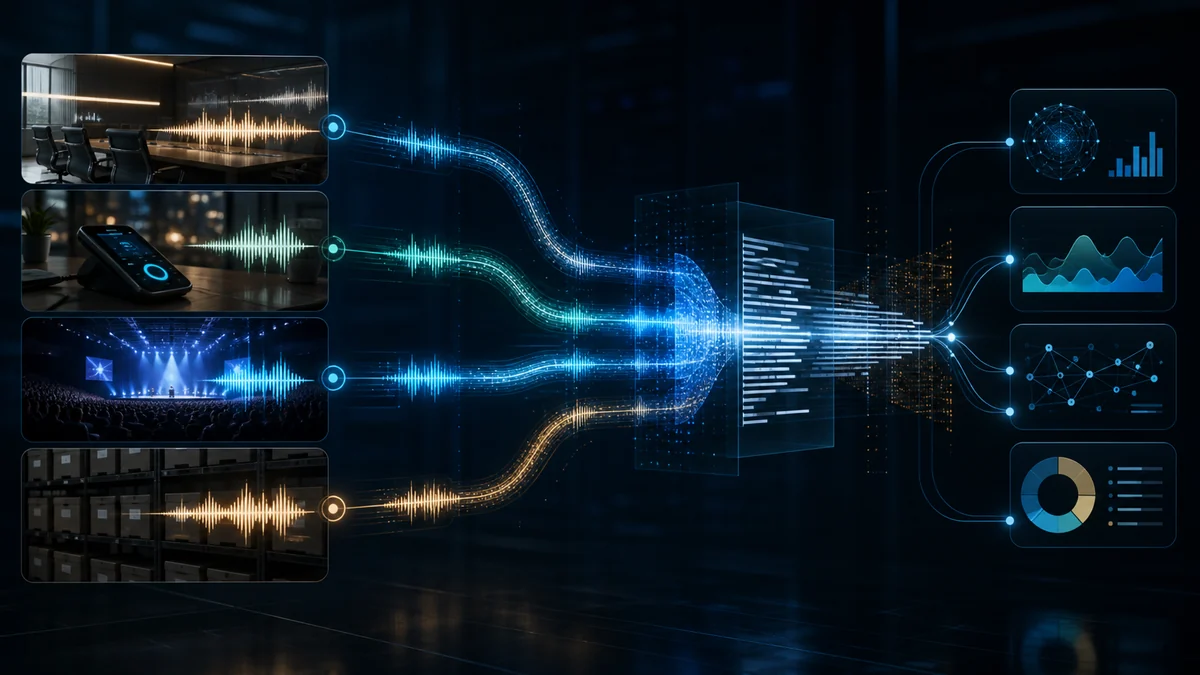
- Subtítulos en tiempo real: para emisiones, clases, conferencias y herramientas de accesibilidad con respuesta casi inmediata.
- Agentes telefónicos: permite convertir cada intervención en texto para que otro modelo consulte datos, prepare una respuesta o active una tarea.
- Reuniones y llamadas: genera actas con hablantes y marcas de tiempo, además de material para resúmenes y extracción de compromisos.
- Entrevistas y pódcast: acelera la edición, la creación de subtítulos y la búsqueda de fragmentos dentro de grabaciones largas.
- Dictado profesional: el vocabulario personalizado puede mejorar el reconocimiento de terminología médica, legal, científica o industrial.
- Atención al cliente: facilita analizar motivos de contacto, detectar incidencias repetidas y revisar la calidad de miles de conversaciones.
- Archivos audiovisuales: transforma grabaciones en material indexable para localizar nombres, temas o momentos concretos.
Disponibilidad y una precaución necesaria
Las dos variantes están disponibles en vista previa pública mediante la API de Gemini, Google AI Studio y Google Antigravity. Las empresas pueden acceder a ellas a través de Gemini Enterprise Agent Platform. En consumo, la aplicación de Gemini para macOS las ofrece inicialmente en inglés; Rambler está limitado a determinados países e idiomas, y Chrome llegará más adelante.
La documentación de la API incluye español latinoamericano y español de Estados Unidos, pero no enumera por separado una configuración es-ES para España en el momento del lanzamiento. Eso no implica que ignore el español peninsular, pero aconseja probar acentos y vocabulario reales antes de desplegar un servicio.
Gemini 3.5 Transcribe puede recortar muchas horas de trabajo, pero una transcripción convincente también puede contener errores difíciles de detectar. En medicina, justicia, cumplimiento normativo o cualquier contexto donde una palabra cambie el sentido, conviene conservar el audio, usar el modo literal y mantener revisión humana. La IA puede limpiar la conversación; la responsabilidad sobre lo que finalmente se publica o se archiva sigue siendo nuestra.