Jalapeño supera a Nvidia Blackwell: los primeros benchmarks del chip de OpenAI en inferencia
Jalapeño, el primer chip de inferencia diseñado por OpenAI, supera a los sistemas Nvidia Blackwell comparados en sus primeros benchmarks públicos. La ventaja combina más trabajo por vatio y respuestas más rápidas: dos mejoras que pueden importar tanto como la inteligencia del propio modelo cuando millones de personas utilizan un servicio a la vez.
Los resultados se publicaron el 25 de agosto de 2026. Conviene situarlos bien: no demuestran que OpenAI haya derrotado a todas las generaciones de Nvidia ni que vaya a prescindir de sus GPU. Sí aportan una señal relevante: su apuesta por el hardware propio ya tiene resultados medibles, más allá de una presentación de intenciones.
Qué es Jalapeño y para qué sirve
El proyecto, presentado en junio junto a Broadcom, consiste en un acelerador concebido desde cero para ejecutar grandes modelos de lenguaje. OpenAI aporta el diseño y el conocimiento de las cargas que quiere atender; Broadcom y Celestica ayudan a convertirlo en una plataforma industrial, desde el silicio y las conexiones hasta las placas y los bastidores.
Su cometido es la inferencia: utilizar un modelo ya entrenado para responder preguntas o realizar tareas. No es lo mismo que entrenarlo, que supone ajustar sus parámetros a partir de datos. Una analogía sencilla: aquí no se construye el conocimiento del asistente, sino que se intenta ponerlo a trabajar con menos espera y menos recursos.
Tampoco es un chip exclusivo para modelos de OpenAI. Las pruebas incluyen sistemas de DeepSeek y Moonshot, algo importante para valorar la flexibilidad de una arquitectura que tendrá que adaptarse a modelos futuros.
Los números frente a Nvidia
En los resultados publicados por OpenAI, Jalapeño ofrece entre 1,5 y 1,9 veces más rendimiento por vatio en el máximo de capacidad, mientras que los tiempos de respuesta completos son entre 1,7 y 3,6 veces menores que los de los sistemas de comparación.
| Modelo probado | Rival Nvidia | Rendimiento por vatio | Latencia: Jalapeño / Nvidia |
|---|---|---|---|
| GPT-OSS 120B | GB200 | 1,9 veces | 1,03 / 1,80 segundos |
| DeepSeek R1 670B | GB300 | 1,7 veces | 1,65 / 5,99 segundos |
| Kimi K2.5 1T | GB300 | 1,5 veces | 1,56 / 5,31 segundos |
Las cifras resumen distintos indicadores del ensayo; el máximo de capacidad y la mínima latencia no deben interpretarse como una única configuración simultánea. La normalización utiliza la potencia nominal del encapsulado: 700 W para Jalapeño, frente a 1.200 W del GB200 y 1.400 W del GB300. No es una medición de la factura eléctrica de todo el centro de datos.
Qué han comprobado los expertos
El análisis de SemiAnalysis es favorable, pero introduce reservas: sus especialistas verificaron ejecuciones de InferenceX presencialmente en el laboratorio, aunque los números proceden de OpenAI y no ejecutaron la batería completa ni vieron resultados de AgentX, más representativo de agentes con conversaciones largas.
Las pruebas divulgadas emplean entradas nominales de 8.000 tokens y salidas de 1.000, con predicción de un token cada vez. No bastan para saber cómo responderá el sistema ante todos los problemas de caché, enrutamiento y conversaciones con múltiples turnos de un servicio real.
También hay una diferencia generacional: Jalapeño usa memoria HBM4, mientras que Blackwell emplea HBM3E. Rubin es una referencia más exigente para la siguiente comparación. Ganar al GB300 resulta significativo, pero no equivale a resolver quién liderará cuando las nuevas plataformas estén desplegadas y optimizadas.
La clave no es únicamente calcular más
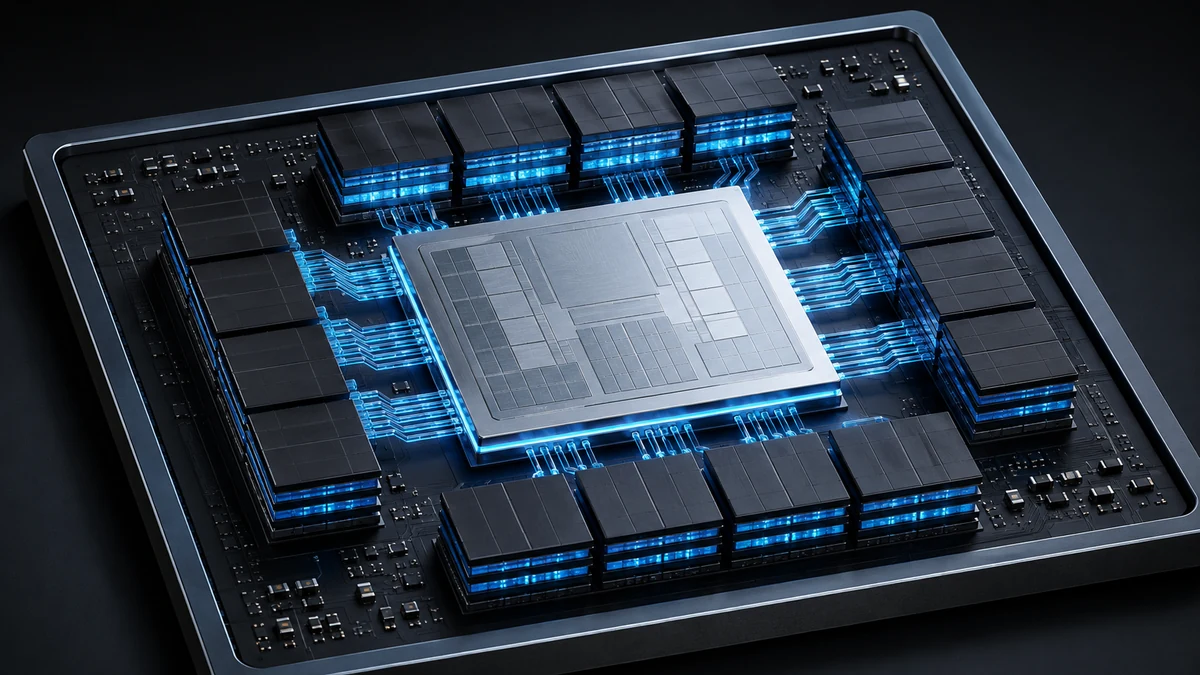
El planteamiento del hardware busca equilibrar cálculo, memoria y comunicaciones, reduciendo desplazamientos de datos. Un procesador muy potente pierde utilidad si pasa demasiado tiempo esperando información. La comparación con una cocina ayuda: añadir más cocineros sirve de poco si todos dependen de un único pasillo para recoger ingredientes.
Por eso importa diseñar conjuntamente el chip, sus conexiones y el software. No se trata simplemente de obtener una cifra espectacular de operaciones teóricas, sino de aprovechar los recursos durante una petición completa. Para el usuario, el resultado valioso no es una especificación técnica: es que la herramienta termine antes sin deteriorar su respuesta.
Una IA que ayuda a diseñar su hardware
Otro dato llamativo son los nueve meses entre el diseño inicial y el tape-out, el cierre del diseño enviado a fabricación. No significa que todo el proyecto, desde contratar al equipo hasta desplegar servidores, durase nueve meses. Los modelos de OpenAI ayudaron en tareas de diseño y optimización; Codex también se utilizó para programar el acelerador.
La lectura interesante es el posible círculo de mejora: mejores herramientas de IA ayudan a desarrollar infraestructura que, a su vez, puede ejecutar IA con mayor eficiencia. Eso no elimina el trabajo de ingeniería, la fabricación ni la validación física. Una simulación prometedora todavía tiene que funcionar sobre silicio.
Qué podría cambiar para empresas y usuarios
La estrategia de OpenAI combina infraestructura propia y proveedores externos. Controlar más capas permite ajustar la plataforma a sus productos y elegir dónde interesa priorizar velocidad, capacidad o coste. No hay una ruptura con Nvidia: la compañía seguirá utilizando sus aceleradores tanto para entrenamiento como para inferencia.
Como posibles aplicaciones prácticas, una latencia menor podría hacer más ágiles los asistentes que revisan código, consultan documentos o encadenan herramientas. En un agente que realiza veinte pasos consecutivos, pequeñas esperas pueden acumularse. Ahora bien, las llamadas a servicios externos también tardan: acelerar el modelo no acelera automáticamente toda la tarea en la misma proporción.
Más capacidad por unidad de energía podría permitir atender más solicitudes con recursos similares. Pero eficiencia no significa una rebaja garantizada de ChatGPT o de la API. También cuentan fabricación, memoria, refrigeración, mantenimiento y decisiones comerciales. El beneficio final habrá que comprobarlo en productos, no deducirlo directamente de una tabla.
Para una empresa que está eligiendo un asistente, conviene separar tres preguntas: cuánto tarda, cuánto cuesta y cuántas veces resuelve bien el encargo. Un chip más rápido mejora la primera variable, pero no demuestra por sí mismo que el modelo razone mejor o cometa menos errores. Revisar una respuesta incorrecta puede consumir más tiempo que el ahorrado al generarla.
Pensemos en atención al cliente: sería útil que el asistente encontrase antes una respuesta en la documentación, especialmente mientras alguien espera al teléfono. Sin embargo, comprobar una identidad, obtener autorización para una devolución o consultar un pedido seguirían teniendo sus propios tiempos. Es ahí donde la prueba de laboratorio debe convertirse en una mejora de servicio perceptible, estable y medible.
Del laboratorio al despliegue
El calendario contempla empezar a incorporar Jalapeño a la infraestructura de OpenAI a finales de 2026 y ampliar su presencia posteriormente. Una segunda generación está avanzada y una tercera empieza a definirse. Todavía quedan pruebas de producción, maduración del software y validación a escala.
Jalapeño debuta con argumentos para competir. Lo decisivo será mantenerlos cuando deje de ser una demostración controlada y pase a sostener servicios cotidianos. Entonces podremos valorar cuánto de esa ventaja llega realmente a quienes utilizan la IA.