Anthropic lanza Claude Sonnet 5.5: más rápido, eficiente y competitivo con Opus
Anthropic ha lanzado Claude Sonnet 5.5, una actualización que busca ocupar el espacio más competitivo del mercado: tareas cotidianas que necesitan buena calidad, rapidez y un coste razonable. El nuevo modelo genera respuestas más de un 30 % más rápido que Sonnet 5, suele consumir menos tokens y mantiene las mismas tarifas de API. Además, en una prueba concreta de programación con agentes ha superado incluso a Claude Opus 5.5.
Una mejora pensada para el trabajo diario
Sonnet 5.5 es el segundo integrante de la familia Claude 5.5, después de Opus 5.5. Anthropic lo presenta para corregir errores de software, generar documentación, analizar información y crear presentaciones, hojas de cálculo o interfaces con buen acabado visual. Es decir, trabajos con un objetivo claro que deben completarse sin la latencia y el precio de un modelo superior.
En el anuncio oficial de Claude Sonnet 5.5, la compañía asegura que el modelo es más colaborativo, escribe con mayor claridad y necesita menos llamadas a herramientas. Algunos clientes de prueba observaron menos pasos para terminar trabajos y una reducción de tokens de salida. También destacaron su capacidad para seguir plantillas y entregar diapositivas o interfaces que requieren menos retoques humanos.
Mismo precio por token, menor coste por tarea
Las tarifas no cambian respecto a Sonnet 5: 2 dólares por cada millón de tokens de entrada y 10 dólares por cada millón de salida. Las lecturas de caché cuestan 0,20 dólares por millón y las escrituras, 2,50 dólares. Anthropic calcula que una tarea puede resultar hasta un 30 % más barata porque el nuevo modelo suele llegar al resultado utilizando menos tokens.
Conviene interpretar bien esa promesa. No hay una rebaja del precio unitario y el ahorro dependerá del tipo de trabajo, del nivel de esfuerzo y de cuánto se prolongue la respuesta. Como señaló el medio español NeoTeo, una evaluación independiente de una versión previa calculó un coste superior al de Sonnet 5 en una prueba concreta con el ajuste Max. Esa versión tenía un error de salida estructurada que Anthropic afirma haber corregido.
Sonnet 5.5 supera a Opus 5.5 en Terminal-Bench
El dato más llamativo aparece en Terminal-Bench 4.0, una evaluación de tareas profesionales complejas ejecutadas desde una terminal. Sonnet 5.5 obtiene un 70,6 %, frente al 10,3 % de Sonnet 5 y el 66,4 % de Opus 5.5 con esfuerzo Xhigh. El salto respecto a su predecesor es enorme y muestra que Anthropic ha reforzado especialmente la programación con agentes.
Sin embargo, este resultado no convierte a Sonnet en un Opus mejor y más barato. En FrontierCode, que valora si una modificación de código podría integrarse sin correcciones humanas, Sonnet 5.5 alcanza un 46,2 % en Max frente al 54,4 % de Opus. En CursorBench queda a unos dos puntos del modelo superior. Y en GDPval-AA, centrado en trabajos reales de distintas profesiones, ambos están prácticamente empatados: 1.844 frente a 1.846 puntos.
Cuándo usar Sonnet y cuándo elegir Opus
Sonnet 5.5 parece la opción lógica para corregir un fallo localizado, escribir pruebas, documentar una función, preparar una presentación desde una plantilla o transformar datos conocidos en una hoja de cálculo. También puede encajar en atención al cliente y procesos empresariales de gran volumen, donde unos segundos o unos miles de tokens menos se multiplican por miles de ejecuciones.
Opus 5.5 conserva ventaja cuando la petición es ambigua, el problema está mal definido o hace falta mantener el criterio durante una investigación larga. Diseñar la arquitectura de un sistema, decidir qué hipótesis explorar o reconciliar información contradictoria son ejemplos en los que la calidad de razonamiento puede importar más que la velocidad. Los benchmarks capturan fragmentos de estas capacidades, pero no sustituyen una prueba con el flujo de trabajo real.
Opus como cerebro y Sonnet como equipo de ejecución
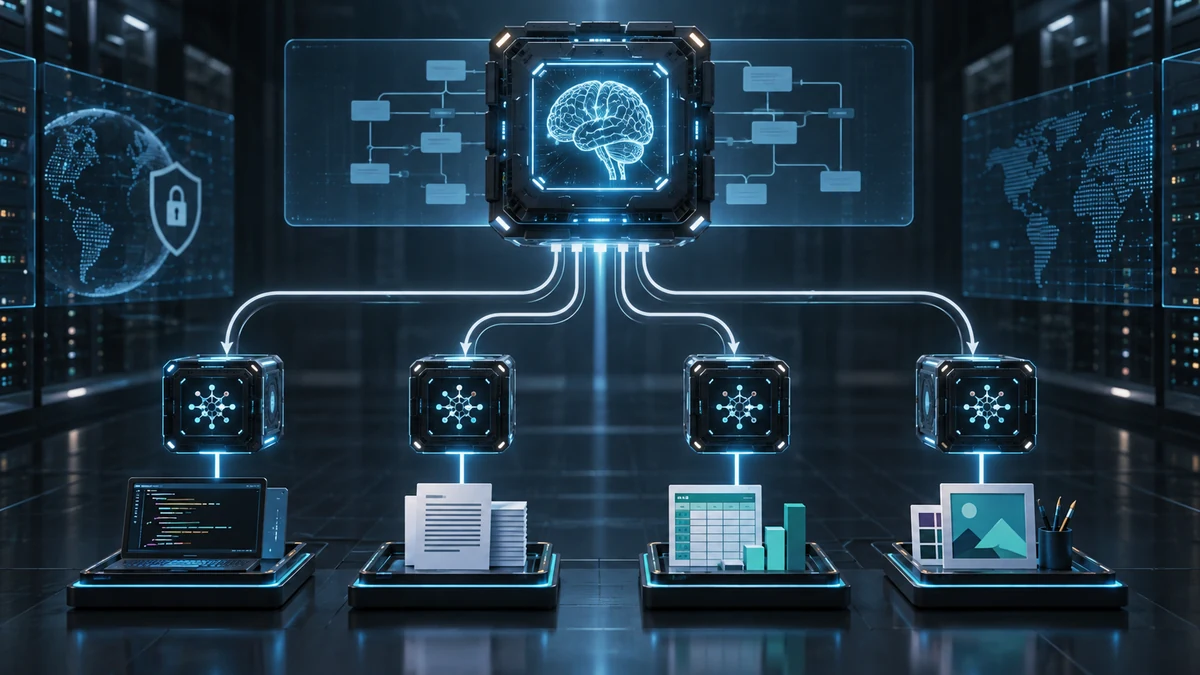
El lanzamiento abre una combinación interesante para los sistemas con varios agentes. Un modelo Opus puede analizar el objetivo, dividirlo en partes y revisar las decisiones delicadas, mientras varias instancias de Sonnet ejecutan en paralelo tareas concretas. Esa arquitectura no ha sido presentada como un producto cerrado por Anthropic, pero es una consecuencia razonable de las diferencias de precio y especialización.
Al reservar el modelo más potente para los momentos que requieren juicio y utilizar Sonnet para el trabajo mecánico, una empresa puede reducir la latencia y aumentar las tareas simultáneas. El desafío será decidir bien qué delegar: una clasificación incorrecta puede enviar un problema complejo al modelo económico y perder el ahorro en reintentos.
Más capacidad implica nuevas protecciones
Sonnet 5.5 es el primer modelo Sonnet que se publica con salvaguardas de ciberseguridad similares a las de los modelos más capaces de Anthropic. Las solicitudes de mayor riesgo pueden derivarse a Sonnet 5, mientras el desarrollo de software habitual debería funcionar con normalidad. También incorpora defensas contra ataques de destilación, destinados a extraer las capacidades del modelo mediante enormes cantidades de consultas.
El modelo está disponible en las aplicaciones de Claude, Claude Code y la API con el identificador claude-sonnet-5-5, además de Amazon Web Services, Google Cloud y Microsoft Azure. Las aplicaciones utilizan por defecto un esfuerzo medio y Claude Platform, uno alto; los desarrolladores pueden ajustarlo para equilibrar calidad, velocidad y gasto. Anthropic adelanta que Claude Haiku 5.5 completará la familia en las próximas semanas.
La conclusión es menos espectacular que declarar un nuevo campeón absoluto, pero probablemente más útil: Claude Sonnet 5.5 acerca prestaciones de primera línea a tareas que deben ejecutarse deprisa y a escala. Si los resultados de producción confirman el ahorro prometido, su mayor impacto no estará en sustituir a Opus, sino en permitir que los modelos potentes trabajen juntos de una forma más eficiente.