Qué es Arena.ai, la antigua LMArena, y por qué se ha convertido en una referencia para comparar modelos de IA
Arena.ai, la plataforma antes conocida como LMArena, se ha convertido en una de las referencias más consultadas para comparar modelos de inteligencia artificial. No porque tenga una fórmula mágica para decir cuál es “el mejor” modelo, sino porque intenta responder a una pregunta mucho más práctica: cuando dos sistemas se enfrentan al mismo encargo, ¿cuál prefiere una persona?
Esa diferencia importa. En IA abundan los benchmarks con nombres técnicos, porcentajes finísimos y tablas que cambian cada semana. Son útiles, claro, pero no siempre capturan lo que ocurre cuando un usuario real pide redactar un correo delicado, resolver un fragmento de código, generar una imagen, resumir un informe largo o contestar una pregunta compleja sin inventarse medio contexto. Arena.ai intenta medir precisamente ese terreno más incómodo y humano: la calidad percibida en usos reales.
De Chatbot Arena a Arena.ai
El proyecto nació en el entorno de LMSYS como Chatbot Arena y después adoptó el nombre LMArena. Su idea central era sencilla y potente: mostrar dos respuestas de modelos distintos de forma anónima, pedir al usuario que elija la mejor y acumular esas votaciones para construir rankings. Con el tiempo, el sistema ha ido creciendo hasta convertirse en una plataforma más amplia. En su propio anuncio de enero de 2026, LMArena explicó que pasaba a llamarse Arena y que ampliaba sus evaluaciones más allá del texto, con áreas como imagen, vídeo y voz.
La clave es que Arena no se limita a preguntar si un modelo acierta una respuesta cerrada. En muchas tareas de IA generativa no hay una única solución correcta. Puede haber una respuesta más clara, otra más creativa, otra más prudente o una que se adapte mejor al tono esperado. Por eso el voto humano tiene valor: recoge matices que un test automático no siempre detecta.
El funcionamiento básico es el de una comparación a ciegas. El usuario escribe un prompt, dos modelos responden sin revelar su nombre y la persona decide cuál gana, si hay empate o si ninguna respuesta convence. A partir de muchas comparaciones, Arena calcula puntuaciones y posiciones. En una explicación técnica publicada por la propia plataforma sobre cómo calcula sus rankings, se describe el uso de modelos estadísticos de preferencias, inspirados en métodos como Bradley-Terry, para convertir duelos individuales en una clasificación agregada.
Cómo leer sus rankings sin confundirse
Una tabla de Arena suele incluir el puesto, la puntuación, el número de votos y, en algunos casos, una horquilla o “rank spread” que refleja la incertidumbre estadística. Esto último es más importante de lo que parece. Si dos modelos aparecen separados por pocos puntos, no conviene interpretar el ranking como una carrera de cien metros en la que uno ha ganado con claridad. A veces la diferencia es estrecha, provisional o depende mucho del tipo de prompts que se estén comparando.
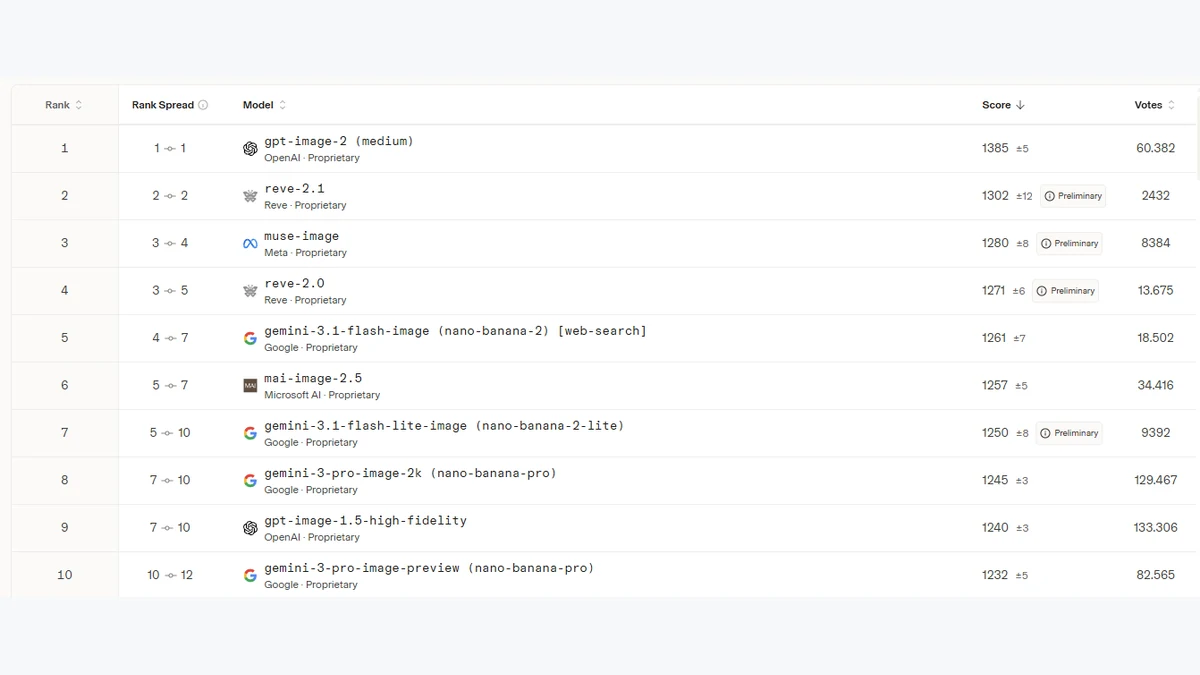
La captura que acompaña este artículo es un buen ejemplo. En ella se ve un ranking de modelos de imagen, con sistemas como gpt-image-2, Reve, Muse o variantes de Gemini para generación visual. Lo interesante no es solo quién ocupa la primera posición, sino cómo leer el conjunto: cuántos votos sostiene cada resultado, qué modelos tienen etiqueta preliminar y si la diferencia de puntuación parece suficientemente amplia. Para un creador visual o un equipo de marketing, esa tabla puede servir como primer filtro antes de probar los modelos en sus propios flujos de trabajo.
Esta es una de las grandes utilidades de Arena.ai: ofrece una fotografía rápida del estado competitivo de los modelos, pero sin obligarte a fiarte únicamente de las promesas comerciales de cada proveedor. Si un modelo aparece consistentemente arriba en escritura, programación, razonamiento, imagen o factualidad, merece atención. Si baja en un área concreta, también es una señal. No definitiva, pero sí útil.
Por qué puede ser útil para empresas y profesionales
Para una empresa, elegir un modelo de IA ya no consiste solo en escoger el más famoso. Hay que ponderar calidad, coste, velocidad, privacidad, disponibilidad por API, contexto máximo, facilidad de integración y comportamiento en el idioma o sector que importa. Arena.ai ayuda en la primera fase de esa decisión porque permite detectar candidatos fuertes. Después, la organización debería hacer sus propias pruebas con documentos, casos de uso y restricciones reales.
Un despacho jurídico, por ejemplo, puede usar Arena para ver qué modelos destacan en respuestas largas y razonamiento, pero no debería contratar uno solo por su posición global. Tendrá que comprobar cómo maneja legislación española, citas, confidencialidad y errores. Una agencia creativa puede mirar el ranking de imagen para seleccionar tres o cuatro opciones prometedoras, pero luego probará consistencia de estilo, edición, derechos de uso y velocidad. Un equipo de atención al cliente, por su parte, quizá valore más la fiabilidad, el tono y la integración con sus sistemas que una puntuación general muy brillante.
En ese sentido, Arena.ai funciona mejor como una herramienta de orientación. No sustituye a una evaluación interna, pero ahorra tiempo. En lugar de probar veinte modelos desde cero, puedes empezar por aquellos que ya han demostrado buen rendimiento en comparaciones públicas. Además, los rankings por categoría ayudan a evitar una trampa habitual: pensar que el modelo ganador en una tarea será automáticamente el mejor en todas las demás.
Más allá del ranking general
La evolución reciente de Arena apunta justo en esa dirección. La plataforma ha ido incorporando leaderboards más específicos y métricas por dominio. En julio de 2026 presentó también un ranking de factualidad orientado a medir respuestas largas a preguntas difíciles, con verificaciones independientes y una atención especial al equilibrio entre cobertura, precisión y exhaustividad. Este tipo de evaluación es relevante porque uno de los grandes problemas de los modelos actuales no es que fallen siempre, sino que pueden sonar convincentes incluso cuando mezclan datos correctos con errores.
La expansión a imagen, vídeo y voz también tiene sentido. La IA generativa ya no vive solo en el chat. Está entrando en editores visuales, asistentes telefónicos, agentes de navegación, herramientas de programación y sistemas internos de empresa. Si Arena consigue evaluar bien esas modalidades, puede convertirse en una capa de referencia para entender qué modelos funcionan mejor en cada tipo de experiencia.
Sus límites: una brújula, no un oráculo
Conviene, aun así, no mitificar Arena.ai. Sus rankings dependen de quién vota, qué prompts se prueban y cómo se distribuyen las comparaciones. Un modelo puede estar muy bien posicionado en inglés y no rendir igual en español. Otro puede ganar por estilo, aunque sea menos prudente con datos delicados. Y algunos resultados marcados como preliminares todavía necesitan más votos para asentarse.
También hay factores que una tabla pública no siempre refleja: coste por millón de tokens, latencia, límites de uso, políticas de datos, estabilidad de la API, facilidad para desplegar en una nube concreta o cumplimiento normativo. Para un usuario individual, quizá baste con saber qué modelo responde mejor. Para una empresa, la decisión completa es bastante más prosaica y, la verdad, más incómoda.
Por eso Arena.ai es más valiosa cuando se usa con criterio. Sirve para descubrir modelos, comparar tendencias, detectar cambios rápidos en el mercado y separar un poco el ruido de los anuncios. Pero la última palabra debería estar en pruebas propias, con tareas reales y criterios claros. En un ecosistema de IA que cambia a una velocidad agotadora, eso ya es mucho: una forma razonable de mirar el tablero sin dejarse arrastrar por cada nuevo titular.