Qué es GLM-5.2 y por qué se compara con los mejores modelos de IA
GLM-5.2 es el nuevo modelo insignia de Z.AI, la compañía china antes conocida internacionalmente como Zhipu AI, y llega con una idea muy clara: competir en el terreno donde hoy se decide buena parte de la carrera de la inteligencia artificial, el de los agentes de programación y las tareas largas. No es un chatbot genérico presentado solo para conversar mejor. Su propuesta se apoya en tres piezas: una ventana de contexto de hasta 1 millón de tokens, salida máxima de 128.000 tokens y capacidades pensadas para ejecutar trabajos de ingeniería completos, desde leer una base de código grande hasta planificar, modificar, probar y documentar cambios.
La novedad ha llamado la atención porque no aparece en un vacío. En los últimos meses, los mejores modelos cerrados han convertido el desarrollo de software en su campo de batalla: Claude, GPT y Gemini compiten por entender repositorios enteros, seguir instrucciones de arquitectura, usar herramientas y completar tareas con menos supervisión. GLM-5.2 entra justo ahí, pero con una diferencia relevante: Z.AI lo presenta como parte de una familia de modelos abiertos o accesibles por API que busca reducir la dependencia de plataformas cerradas.
Qué es exactamente GLM-5.2
Según la documentación oficial de Z.AI, GLM-5.2 es un modelo fundacional de texto orientado a tareas de largo recorrido. La compañía lo describe como su modelo de codificación más potente hasta la fecha, capaz de manejar contexto de proyecto, contratos de API, estructura de directorios, decisiones históricas y reglas de ingeniería sin perder tanto el hilo cuando la tarea se alarga.
Ese detalle importa más de lo que parece. En pruebas sencillas, casi cualquier modelo moderno puede escribir una función o explicar un fragmento de código. El problema llega cuando la petición exige mantener coherencia durante decenas de archivos, entender dependencias, respetar límites de arquitectura y cerrar el trabajo con pruebas. Ahí los modelos suelen degradarse: olvidan restricciones, introducen dependencias no deseadas, cambian comportamientos colaterales o dejan pasos sin verificar.
GLM-5.2 intenta atacar justo esa zona gris entre “asistente que sugiere” y agente que trabaja durante mucho rato. Z.AI habla de casos como auditorías técnicas, refactorizaciones largas, migraciones de API, desarrollo móvil con depuración en dispositivo, mini programas de WeChat, creación de minijuegos y reproducción de papers. Es decir, escenarios donde el modelo necesita más memoria operativa, mejor disciplina y una capacidad de planificación más estable.
La comparación con modelos de primer nivel
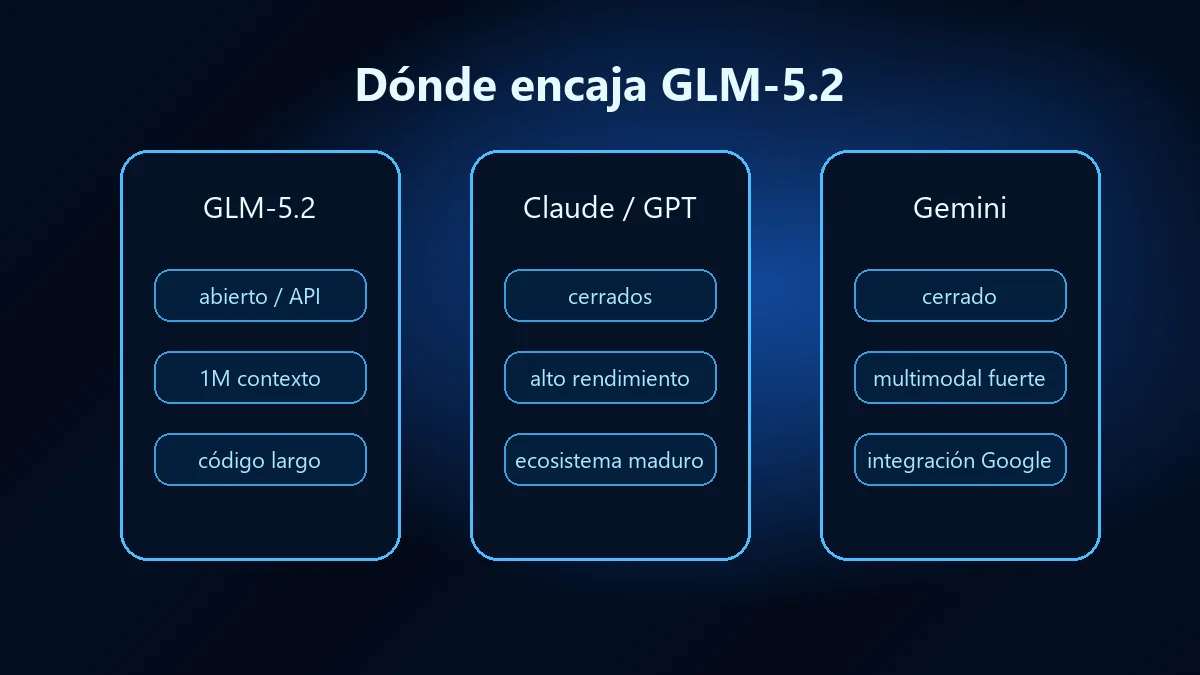
La pregunta inevitable es cómo se compara con los modelos de primera línea. Aquí conviene separar marketing, benchmarks y uso real. Z.AI afirma que GLM-5.2 queda cerca de Claude Opus 4.8 en algunas pruebas de ingeniería y que supera a GPT-5.5 y a Gemini 3.1 Pro en varios benchmarks publicados por la propia compañía. Además, medios como Business Insider han destacado el interés que el modelo está generando entre desarrolladores e inversores de Silicon Valley, especialmente por su rendimiento en código y su enfoque abierto.
La lectura prudente sería esta: GLM-5.2 parece estar mucho más cerca de la frontera de lo que se esperaba de un modelo chino abierto hace apenas un año, pero eso no significa que haya “derrotado” de forma definitiva a Claude, GPT o Gemini. Los benchmarks son útiles, aunque incompletos. Miden cortes concretos de capacidad, no siempre reflejan la calidad de una integración en producción y pueden favorecer determinados estilos de tarea.
Frente a Claude, GLM-5.2 compite especialmente en tareas de código largo y seguimiento de instrucciones. Claude mantiene una reputación muy fuerte en razonamiento, escritura técnica y uso dentro de flujos empresariales maduros. Frente a GPT, la comparación pasa por ecosistema, herramientas, estabilidad de plataforma y disponibilidad global. Frente a Gemini, el contraste es algo distinto: Google suele destacar en multimodalidad e integración con su infraestructura, mientras que GLM-5.2 se presenta, sobre todo, como una herramienta para ingeniería textual y agentes de software.
Por qué el contexto de 1 millón de tokens no lo explica todo
Uno de los titulares más llamativos es el contexto de 1 millón de tokens. Suena enorme, y lo es. En teoría, permite introducir documentación extensa, repositorios grandes, conversaciones largas o especificaciones completas sin trocearlo todo. Pero el propio valor del modelo depende de algo más fino: que ese contexto sea realmente utilizable.
Un modelo puede aceptar mucho texto y aun así no razonar bien sobre él. Puede “ver” un archivo al principio de la conversación y después ignorar una restricción crítica. Por eso Z.AI insiste en la estabilidad en tareas de largo horizonte. La promesa no es solo meter más tokens, sino sostener decisiones de ingeniería durante una ejecución prolongada.
En la práctica, esto puede marcar diferencia en empresas con repositorios grandes, documentación dispersa y normas internas muy concretas. Un equipo podría pedirle al modelo que lea el proyecto, identifique módulos, proponga una migración y ejecute cambios respetando reglas de estilo, tests y límites de arquitectura. Ese es el tipo de flujo que convierte a un LLM en una pieza de productividad real, no en una simple caja de respuestas.
Cómo se puede usar GLM-5.2
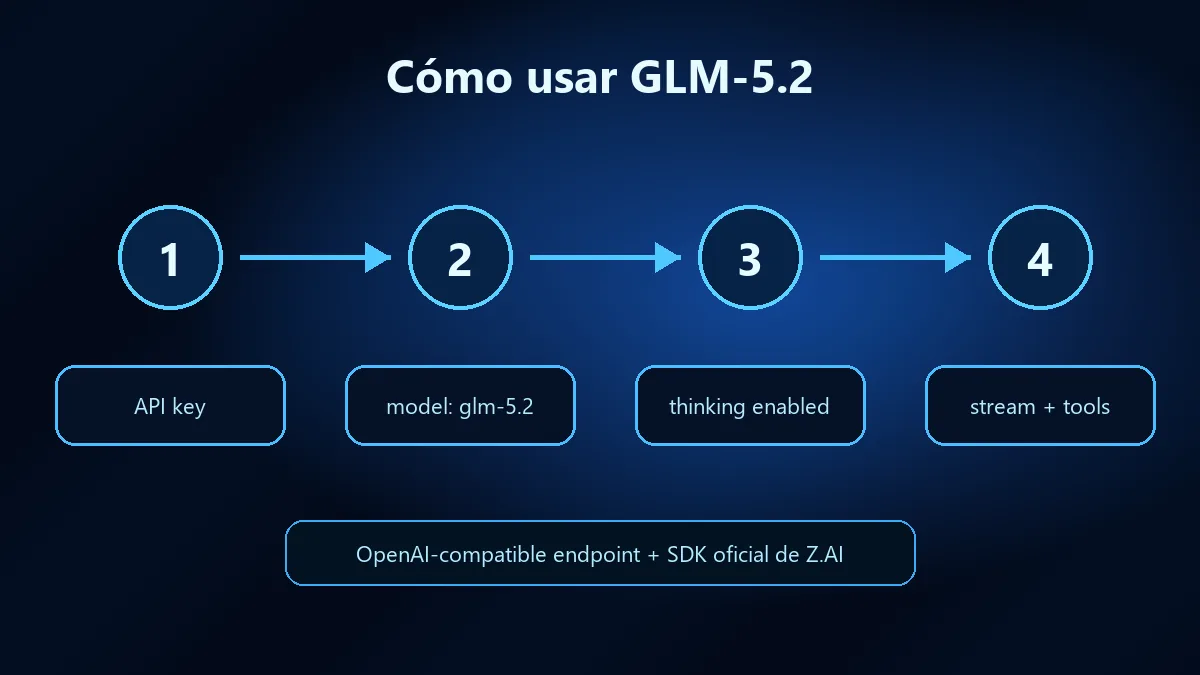
La forma más directa de probarlo es mediante la plataforma de Z.AI. La documentación explica un flujo bastante estándar: crear una API key, elegir el modelo glm-5.2 y llamar al endpoint de chat completions. La API es compatible con el estilo de OpenAI, así que un desarrollador puede usar el SDK oficial de Z.AI o adaptar código existente con el cliente de OpenAI cambiando la base_url a https://api.z.ai/api/paas/v4/.
Para tareas complejas, Z.AI recomienda activar el modo de pensamiento con thinking={"type":"enabled"} y controlar la profundidad con reasoning_effort, especialmente en valores como high o max. También soporta streaming, llamadas a funciones, salida estructurada, caché de contexto y herramientas MCP, lo que lo coloca en la misma conversación que los modelos modernos pensados para agentes.
Un uso básico sería pedirle que analice un repositorio y devuelva un mapa de arquitectura. Un uso más avanzado sería darle una tarea delimitada de refactorización, exigir que no cambie contratos públicos, pedir una estrategia de verificación y hacer que ejecute pruebas. Lo interesante no es que escriba código, sino que sea capaz de mantener el criterio durante todo el proceso.
Coste, apertura y dependencia tecnológica
Otro punto relevante es el coste. En su página de precios, Z.AI sitúa GLM-5.2 en 1,4 dólares por millón de tokens de entrada y 4,4 dólares por millón de tokens de salida, con descuentos para entrada cacheada. Estas cifras pueden cambiar, pero ayudan a entender la estrategia: competir no solo en calidad, sino también en economía de uso para desarrolladores y empresas.
La apertura también tiene una dimensión estratégica. Los modelos cerrados ofrecen una experiencia muy pulida, pero obligan a depender del proveedor. Los modelos abiertos o más portables permiten más control, personalización y despliegues adaptados, aunque suelen exigir más trabajo técnico. Para una empresa, esa diferencia puede pesar tanto como un benchmark: privacidad, regulación, coste, latencia, soberanía tecnológica y capacidad de auditar el sistema.
El matiz importante: no todos los usos son iguales
GLM-5.2 no debería evaluarse como si todos los modelos sirvieran para lo mismo. Para redacción general, análisis multimodal, asistencia jurídica, investigación científica o atención al cliente, puede que otros modelos sigan siendo más convenientes por idioma, herramientas, integración o garantías empresariales. Su punto fuerte aparente está en el código, los agentes y los contextos largos.
También habrá que comprobar cómo se comporta fuera de los ejemplos que mejor encajan con su diseño. La calidad en español, la robustez en tareas no técnicas, la seguridad, la gestión de alucinaciones y la estabilidad real bajo carga son aspectos que no se resuelven con un gráfico de benchmarks. Para adoptarlo con seriedad, lo razonable es probarlo con tareas propias, compararlo contra el modelo que ya se usa y medir resultados: tiempo ahorrado, errores introducidos, coste, latencia y facilidad de integración.
Una señal clara de hacia dónde va la IA
GLM-5.2 importa porque confirma una tendencia: la competición ya no va solo de quién responde mejor a una pregunta, sino de quién puede asumir trabajos largos con contexto real. Los modelos de primer nivel se están desplazando hacia agentes capaces de entender sistemas completos, usar herramientas, seguir reglas y entregar resultados verificables.
Si Z.AI consigue que GLM-5.2 funcione de forma consistente en ese terreno, el impacto puede ser notable. No porque vaya a sustituir de golpe a GPT, Claude o Gemini, sino porque añade presión en una zona muy sensible: la de los modelos potentes, relativamente abiertos y pensados para desarrolladores. Y en IA, cuando un modelo abierto se acerca lo suficiente a la frontera, toda la industria se ve obligada a moverse un poco más rápido.